Prioriser les incidents
Vue d'ensemble
Avec potentiellement des centaines ou des milliers d'incidents de secrets publics à examiner, une priorisation efficace est essentielle pour concentrer vos efforts de remédiation sur les secrets qui présentent le plus grand risque pour votre organisation.
Ce guide explique les capacités disponibles pour vous aider à identifier les incidents nécessitant une attention immédiate et à créer un flux de remédiation efficace.
Risk score
Chaque incident public possède un risk score de 0 à 100, où 100 indique le risque le plus élevé. Il alimente la colonne du score, le tri et le filtrage dans le tableau des incidents, de sorte que le tri sur ce score vous donne une file ordonnée à traiter.
Le score est défini par les agents qui analysent vos incidents publics, ainsi qu'un verdict Company-related. Un incident jugé Unrelated par les agents obtient toujours un score de 0, et un incident qui n'a pas encore été analysé a un score vide plutôt que 0. Consultez Analyse des agents pour comprendre ce que mesure le score et comment l'exploiter.
L'analyse des agents est déployée progressivement et n'est pas encore activée sur tous les workspaces. Si la colonne et le filtre Company-related n'apparaissent pas dans votre liste d'incidents publics, votre workspace n'a pas encore été basculé : contactez support@gitguardian.com pour en faire la demande.
Comportement précédent : le risk score ML
Sur les workspaces qui n'ont pas été basculés vers l'analyse des agents, le risk score est produit par le modèle de machine learning de GitGuardian.
Le risk score est une fonctionnalité basée sur l'ML qui évalue automatiquement le niveau de risque de chaque incident sur une échelle de 0 à 100, où 100 indique le risque le plus élevé nécessitant une attention immédiate et 0 indique le risque le plus faible. Il fournit une couche supplémentaire de priorisation en analysant plusieurs signaux de risque pour vous aider à vous concentrer sur les incidents qui posent la plus grande menace.
Le risk score complète le scoring de sévérité en fournissant une évaluation des risques plus granulaire et continuellement mise à jour.
Fonctionnement du risk score ML
Le risk score est calculé en utilisant des modèles de machine learning qui prennent en compte divers facteurs notamment :
- Type de secret
- Validité (passée ou présente)
- Contexte de détection (fichiers de test, fichiers sensibles, environnement de production, etc.)
- Schémas d'exposition du secret
- Signaux contextuels supplémentaires
Le score est dynamique et se recalcule régulièrement pour refléter les changements dans le profil de risque de l'incident.
Utiliser le risk score dans votre flux de travail
Le risk score utilise des modèles de machine learning qui sont continuellement améliorés sur la base des retours utilisateurs. Si vous remarquez des incidents avec des scores ou des explications inattendus, nous vous encourageons à partager vos retours directement via le dashboard — votre contribution nous aide à affiner le modèle de scoring.
Dans le tableau des incidents
Le risk score peut être utilisé pour prioriser les incidents de plusieurs façons :
Filtrage et tri :
- Filtrer par plage de risk score : utilisez le filtre "Risk score" pour vous concentrer sur des niveaux de risque spécifiques (par exemple, Risk score ≥ 80 pour la priorité la plus élevée)
- Trier par risk score : sélectionnez "Sort by Risk score" pour ordonner les incidents par priorité
- Utiliser la vue sauvegardée "Critical" : cette vue préconfigurée affiche tous les incidents ouverts avec un risk score supérieur à 80/100, vous donnant un accès rapide aux incidents de plus haute priorité
Ajouter la colonne Risk score :
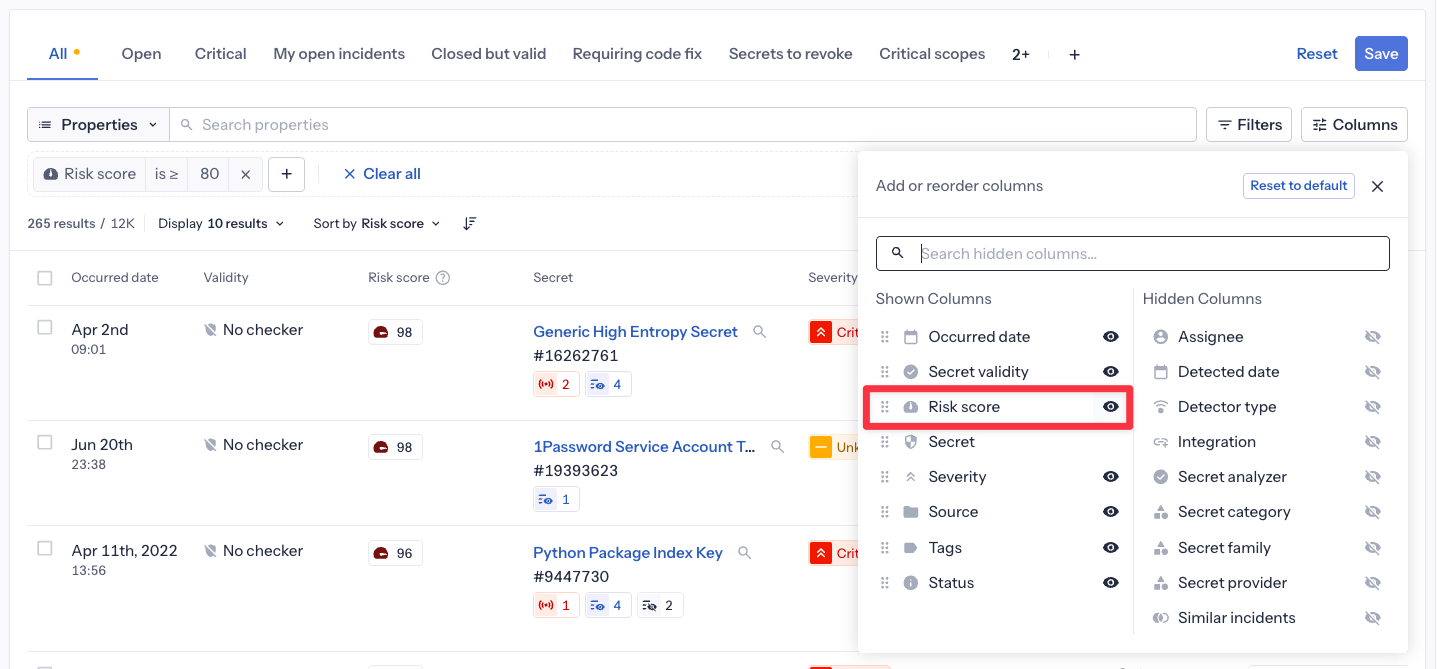
Par défaut, la colonne risk score n'est pas affichée dans la table d'incidents. Pour voir les valeurs de score réelles :
- Cliquez sur le bouton Columns en haut à droite de la table d'incidents
- Trouvez "Risk score" dans la liste des colonnes disponibles
- Cliquez sur l'icône œil pour le rendre visible
- La colonne apparaîtra maintenant dans votre table, affichant le score de 0 à 100 pour chaque incident
Dans la page de détail de l'incident
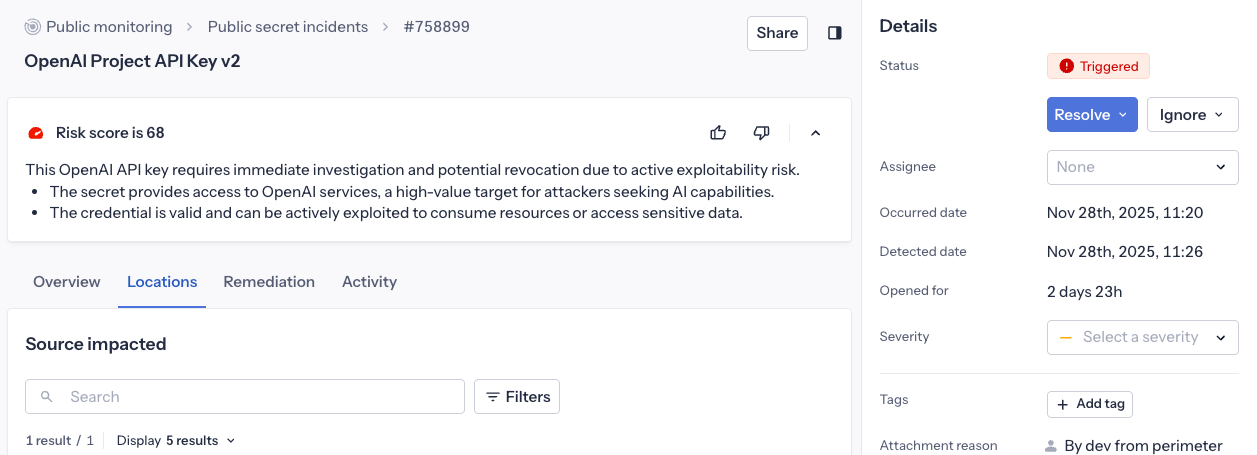
Lors de l'investigation d'un incident, vous trouverez le risk score en haut de la page de détail de l'incident affichant :
- Le risk score actuel (0-100) avec un indicateur visuel
- Une explication détaillée de ce qui détermine le score, basée sur le contexte et les caractéristiques de l'incident, afin que vous sachiez quoi prioriser.
- Boutons de retour pour nous aider à améliorer la fonctionnalité (pouce vers le haut/bas)
Remarque pour les incidents publics : le risk score ML reflète le risque technique du secret lui-même, et non sa pertinence par rapport à votre entreprise. Pour évaluer le risque réel pour votre organisation, combinez-le avec des indicateurs de relation avec l'entreprise (comme le domaine de l'e-mail de l'auteur ou la propriété du dépôt).
Évolution du score :
Le risk score est dynamique et se recalcule régulièrement à mesure que le contexte de l'incident évolue. Les changements dans le contexte de détection, les schémas d'exposition ou d'autres signaux de risque peuvent amener le score à s'ajuster au fil du temps. De plus, notre modèle ML est continuellement amélioré, ce qui peut conduire à des affinements de score.
Donner un retour :
Vos retours nous aident à améliorer continuellement le modèle ML. Sur la page de détail de l'incident, vous pouvez :
- Examiner le risk score et son explication
- Utiliser le bouton pouce vers le haut si le score reflète précisément le risque, ou le bouton pouce vers le bas si le score ne correspond pas à votre évaluation
- Développer/réduire l'explication à l'aide du bouton flèche
Les retours sont examinés par notre équipe pour affiner régulièrement l'algorithme de scoring.
Risk score ML vs. sévérité
Les deux outils aident à la priorisation mais servent des objectifs différents :
| Fonctionnalité | Risk Score | Sévérité |
|---|---|---|
| Calcul | Basé sur l'ML, automatique | Basé sur des règles, peut être manuel |
| Granularité | Échelle 0-100 | 6 niveaux (Critical à Unknown) |
| Mises à jour | Dynamique, se recalcule automatiquement | Statique sauf si modifié manuellement ou règles recalculées |
| Idéal pour | Évaluation des risques granulaire | Catégorisation basée sur les politiques |
Sévérité et règles de sévérité
La sévérité consolide plusieurs facteurs de risque en un seul niveau de priorité exploitable. Contrairement au risk score, elle peut être personnalisée pour correspondre à vos propres priorités.
Les niveaux de sévérité possibles sont : Critical, High, Medium, Low, Info, Unknown.
Règles de sévérité
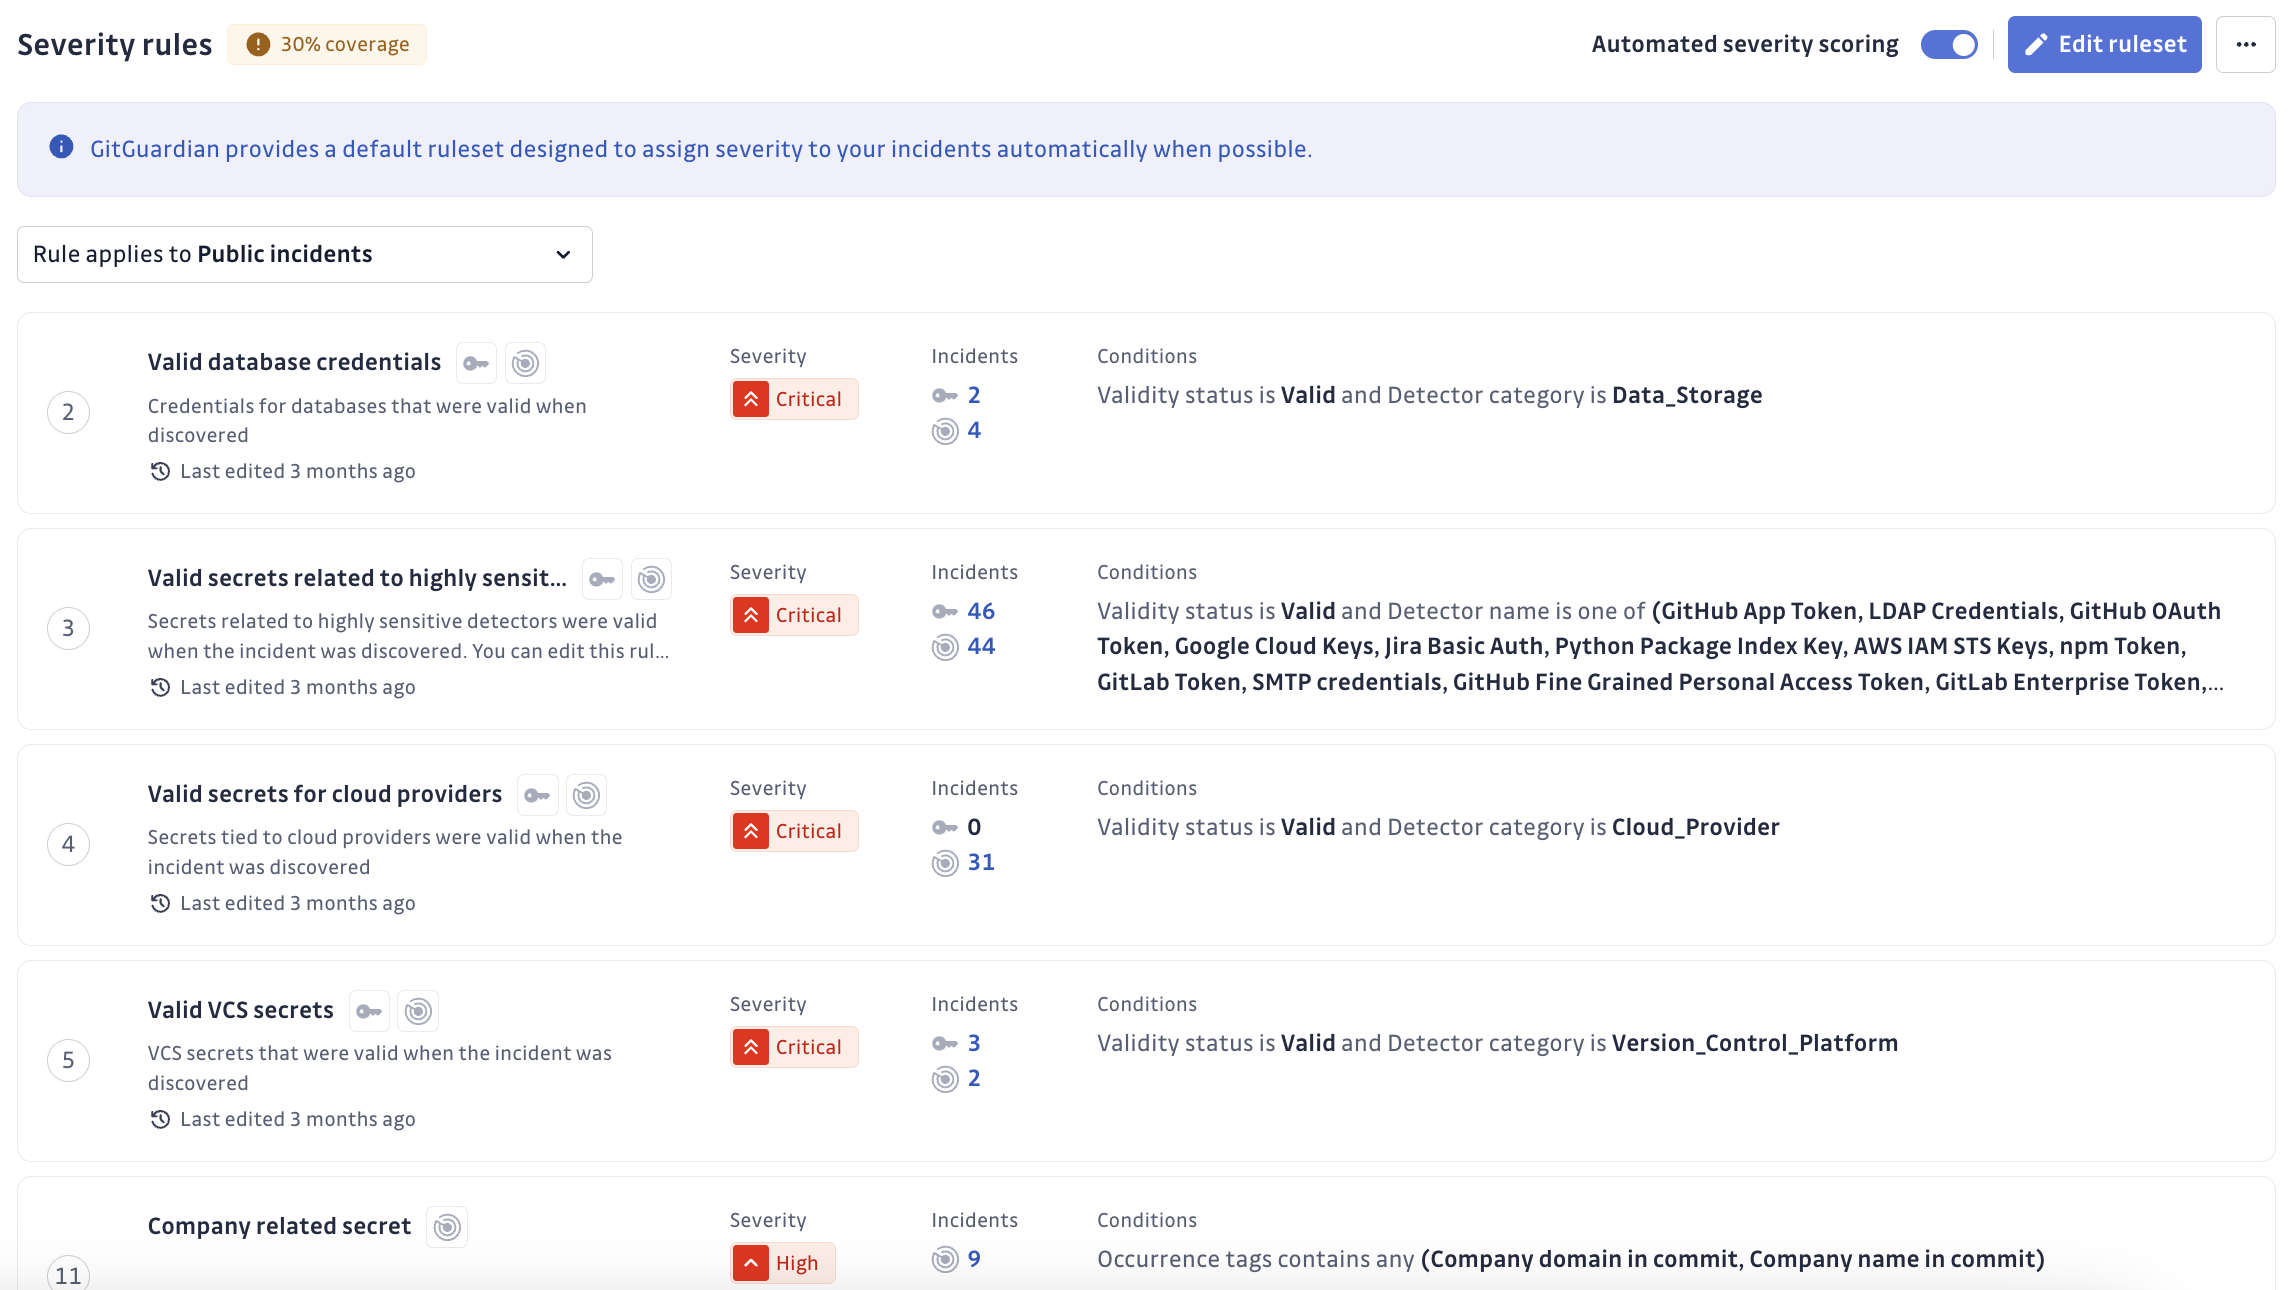
Les règles de sévérité évaluent automatiquement les incidents en fonction de divers facteurs (type de secret, pertinence organisationnelle, validité, indicateurs d'entreprise) et attribuent les niveaux de priorité en conséquence.
Votre workspace est fourni avec les règles de sévérité par défaut de GitGuardian, que vous pouvez personnaliser dans Settings > Severity rules pour correspondre aux priorités de risque spécifiques de votre organisation.
Lors de la création ou de la modification d'une règle de sévérité, vous pouvez spécifier si elle s'applique aux incidents publics, aux incidents internes (issus d'Internal Monitoring), ou aux deux.
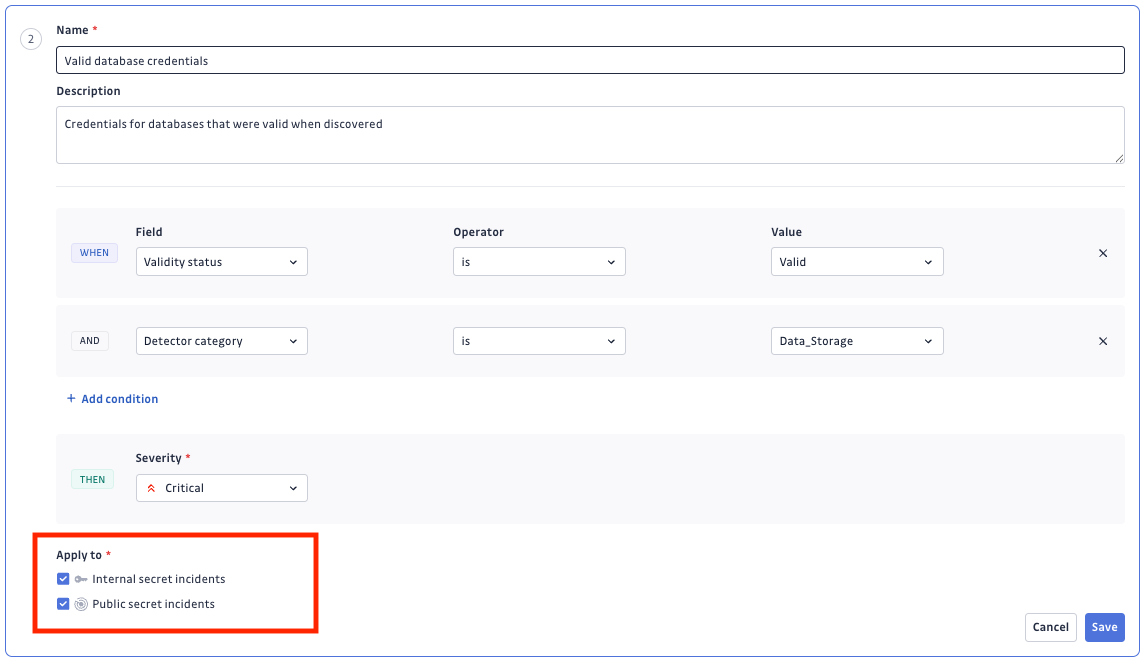
Certains critères de règle ne s'appliquent qu'à des types d'incidents spécifiques. Par exemple, les tags liés à l'entreprise sont propres à Public Monitoring, donc les règles utilisant ces critères désactiveront automatiquement l'option « incidents internes ».
Les incidents dont la sévérité est « Unknown » indiquent qu'ils ne correspondent à aucune règle de sévérité configurée — ils peuvent nécessiter une revue manuelle ou une configuration de règle supplémentaire.
Remplacement manuel de la sévérité
Vous pouvez modifier manuellement la sévérité de n'importe quel incident pour remplacer l'attribution automatique lorsque vous disposez d'un contexte supplémentaire ou que vous n'êtes pas d'accord avec l'évaluation automatisée.
Risk score vs. sévérité
Les deux outils vous aident à prioriser, et ils répondent à des questions différentes.
| Risk score | Sévérité | |
|---|---|---|
| Défini par | Les agents de GitGuardian (ou le modèle ML sur les workspaces pas encore basculés) | Vos règles de sévérité, ou manuellement |
| Personnalisable | Non | Oui, via les règles de sévérité |
| Remplacement sur un incident unique | Non | Oui |
| Granularité | 0-100 | 6 niveaux, de Critical à Unknown |
| Idéal pour | Ordonner la file par risque réel | Encoder votre propre politique |
Utilisez le risk score pour décider par quoi commencer. Utilisez la sévérité lorsque vous devez encoder quelque chose de spécifique à votre organisation : un type de secret que vous traitez toujours comme Critical, une règle sur laquelle votre équipe s'est mise d'accord, ou une évaluation que vous avez faite vous-même sur un incident unique.
Tableau des incidents
Le tableau des incidents de secrets publics est l'endroit où vous appliquerez ces stratégies de priorisation, ainsi que des capacités de filtrage et de tri supplémentaires. Le tableau est fourni avec plusieurs outils pour vous aider à avoir une vue plus claire de votre liste d'incidents.
Filtrage et tri
Au-delà du risk score et de la sévérité, le tableau prend en charge des filtres pour une priorisation plus ciblée :
- Pertinence pour l'entreprise : verdict Company-related, raisons de rattachement
- Indicateurs de risque : validité du secret, type de secret
- Contexte : tags GitGuardian, et vos propres tags personnalisés
Le risk score et Company-related peuvent être triés ainsi que filtrés.
Vues enregistrées
Créez et enregistrez des combinaisons de filtres pour un accès rapide à des ensembles d'incidents spécifiques. GitGuardian fournit des vues par défaut pour vous aider à démarrer, mais vous pouvez créer des vues enregistrées personnalisées basées sur vos stratégies de filtrage les plus fréquemment utilisées. Sur les workspaces disposant de l'analyse des agents, les vues par défaut pour les incidents publics en incluent trois basées sur le verdict Company-related.
Tags personnalisés
Créez et attribuez vos propres tags personnalisés pour marquer les incidents selon vos flux de travail spécifiques. Ces tags personnalisés peuvent ensuite être utilisés dans les filtres et les vues enregistrées pour répondre aux besoins de priorisation uniques de votre organisation.
Étapes suivantes : de la priorisation à la remédiation
Une fois que vous avez identifié et priorisé vos incidents publics les plus critiques, vous êtes prêt à commencer une remédiation systématique.
Ce que vous devriez avoir après la priorisation :
- Une liste ciblée d'incidents hautement prioritaires qui appartiennent clairement à votre organisation
- Évaluation du risque - comprendre quels secrets représentent la plus grande menace
- Organisation du flux de travail - les incidents critiques en premier, les moins urgents planifiés pour plus tard
- Critères clairs - des règles établies pour distinguer ce qui relève de la priorité immédiate ou standard
Passez à la phase de remédiation pour :
- Distinguer les incidents nécessitant une action immédiate de ceux qui peuvent être ignorés
- Impliquer les développeurs et les parties prenantes pour les menaces confirmées
- Suivre des procédures de remédiation structurées pour les expositions publiques
- Mettre en œuvre des procédures de nettoyage et de surveillance appropriées

