Machine learning
Détecter des secrets avec des résultats de haute qualité est une tâche complexe et délicate. Pour améliorer notre moteur de détection, nous avons implémenté divers modèles de machine learning afin d'analyser le code comme un développeur professionnel, d'identifier les faux positifs et d'enrichir les secrets génériques avec des informations contextuelles.
False Positive Remover
Seuls les workspaces disposant d'un plan Business peuvent accéder à cette fonctionnalité.
Lorsqu'il s'agit d'éviter les faux positifs, nous avons poussé la programmation impérative et les expressions régulières à leurs limites. Il est tout simplement impossible d'écrire des conditions ou des motifs d'expressions régulières pour chaque scénario potentiel.
Pour surmonter cette contrainte technologique, nous avons implémenté le machine learning afin d'entraîner les machines à parcourir rapidement et efficacement ce domaine complexe et à identifier les éléments que nous recherchons.
Le False Positive Remover identifie et étiquette avec précision les incidents comme « faux positifs » grâce à son analyse approfondie.
Le False Positive Remover s'exécute sur les findings de toutes vos sources, pas seulement vos dépôts de code. Cela inclut les sources autres que le code, telles que Confluence, Jira, Slack et Microsoft Teams. Chaque nouveau finding de ces sources passe automatiquement par le modèle, de sorte que les secrets génériques peuvent être détectés sur des sources autres que le code sans inonder votre dashboard de faux positifs.
- Pour les VCS, le False Positive Remover est un modèle développé et entraîné en interne, indépendant des services tiers, qui identifie et étiquette avec précision les incidents comme « faux positifs » grâce à son analyse approfondie.
- Pour les sources autres que le code, le filtrage des faux positifs repose sur un modèle basé sur un LLM et nécessite l'activation des fonctionnalités d'IA dans votre workspace. Consultez les paramètres d'IA.
Comment l'utiliser ?
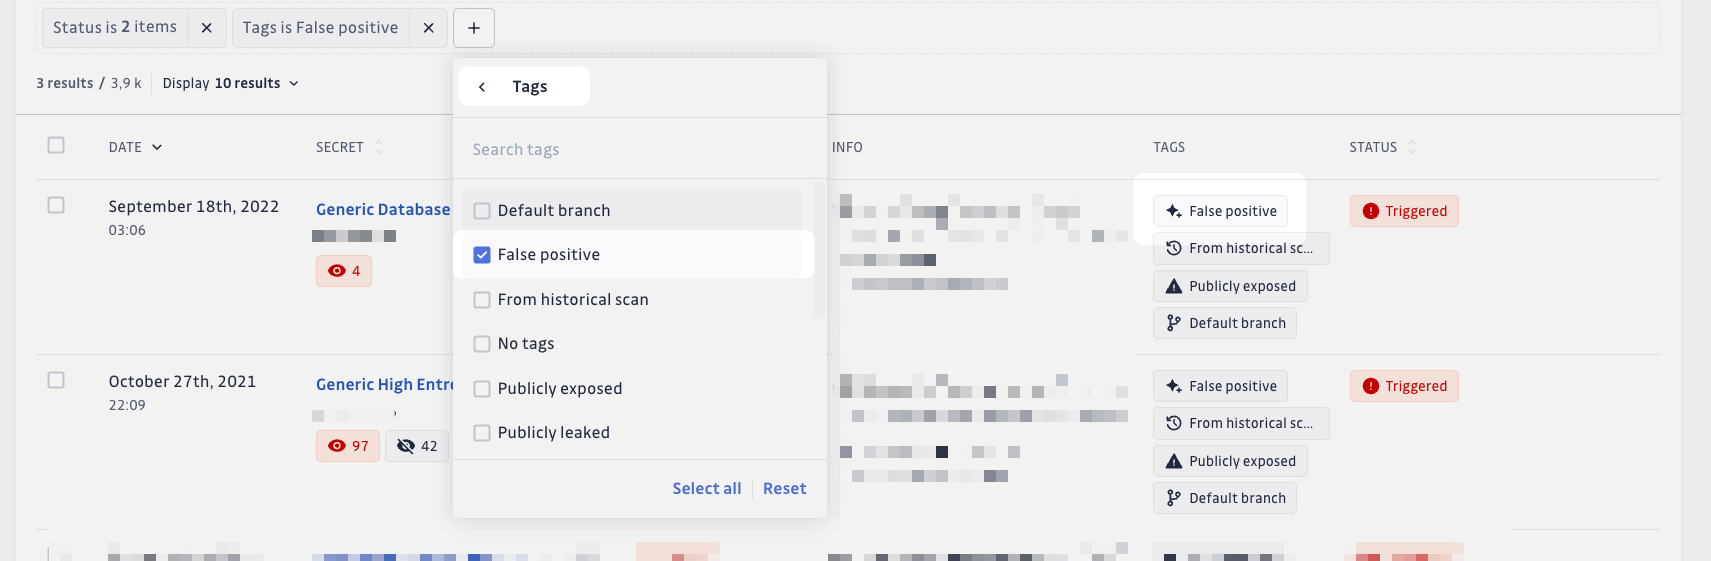
Vous pouvez améliorer votre flux de travail en utilisant le filtre Filters > GitGuardian tags > False positive situé sur la page de la liste des incidents.
Ce filtre vous permet d'identifier et de gérer facilement les incidents faux positifs, ce qui vous aide à rationaliser votre processus de résolution des incidents.
En savoir plus sur notre article de blog
FAQ
Que considère ce modèle comme un « faux positif » ?
Quelque chose qui ne peut être un secret dans aucun contexte.
Dans l'exemple ci-dessous ("signup_form_confirm_password": " Confirmar contrasinal"), cela ressemble à un vrai positif pour une regex, mais pas pour notre modèle qui analyse un contexte (lignes avant/après)
{
	"signup_form_username": "Identificador",
	"signup_form_password": "Contrasinal",
	"signup_form_confirm_password": " Confirmar contrasinal", <- a regex may consider this a true positive, not our model.
	"signup_form_button_submit": "Crear conta",
}
Si ce sont des faux positifs, pourquoi ne pas simplement les supprimer ?
Nous les étiquetons comme faux positifs plutôt que de les supprimer afin que vous conserviez une visibilité totale et gardiez le contrôle. Vous pouvez les filtrer de votre vue, et vous pouvez toujours consulter ce qui a été étiqueté.
Détectez-vous tous les faux positifs que j'ai ?
Le modèle fonctionne avec une haute précision (environ 95 %) afin d'éviter d'étiqueter de vrais secrets comme faux positifs. Sur les secrets génériques provenant de sources autres que le code, il filtre en moyenne 25 à 40 % des findings. Nous continuons d'améliorer le rappel au fil du temps tout en préservant la précision.
Secret Enricher
Secret Enricher est un modèle de machine learning spécialisé conçu pour analyser le contexte autour des secrets génériques et les classer automatiquement en catégories et fournisseurs. Cette classification améliorée vous aide à prioriser les efforts de remédiation en comprenant l'impact potentiel et la criticité de chaque incident.
Cette fonctionnalité est spécialement conçue pour les incidents génériques qui n'ont pas pu être associés à un détecteur spécifique. Le Secret Enricher analyse le contexte environnant pour fournir des informations sur la catégorie et le fournisseur, ce qui facilite la priorisation et la remédiation.
Affichage des incidents piloté par l'enrichissement
Lorsque Secret Enricher enrichit avec succès un incident générique, le nom du secret enrichi remplace automatiquement le nom du détecteur générique. Cela signifie qu'au lieu de voir des noms vagues comme « Generic Database Assignment » ou « Generic High Entropy Secret », vous verrez des noms précis et exploitables :
- Redis Identifiers au lieu de « Generic Database Assignment »
- Stripe API Key au lieu de « Generic High Entropy Secret »
- PostgreSQL Connection String au lieu de « Generic Database Assignment »
- AWS Access Key au lieu de « Generic High Entropy Secret »
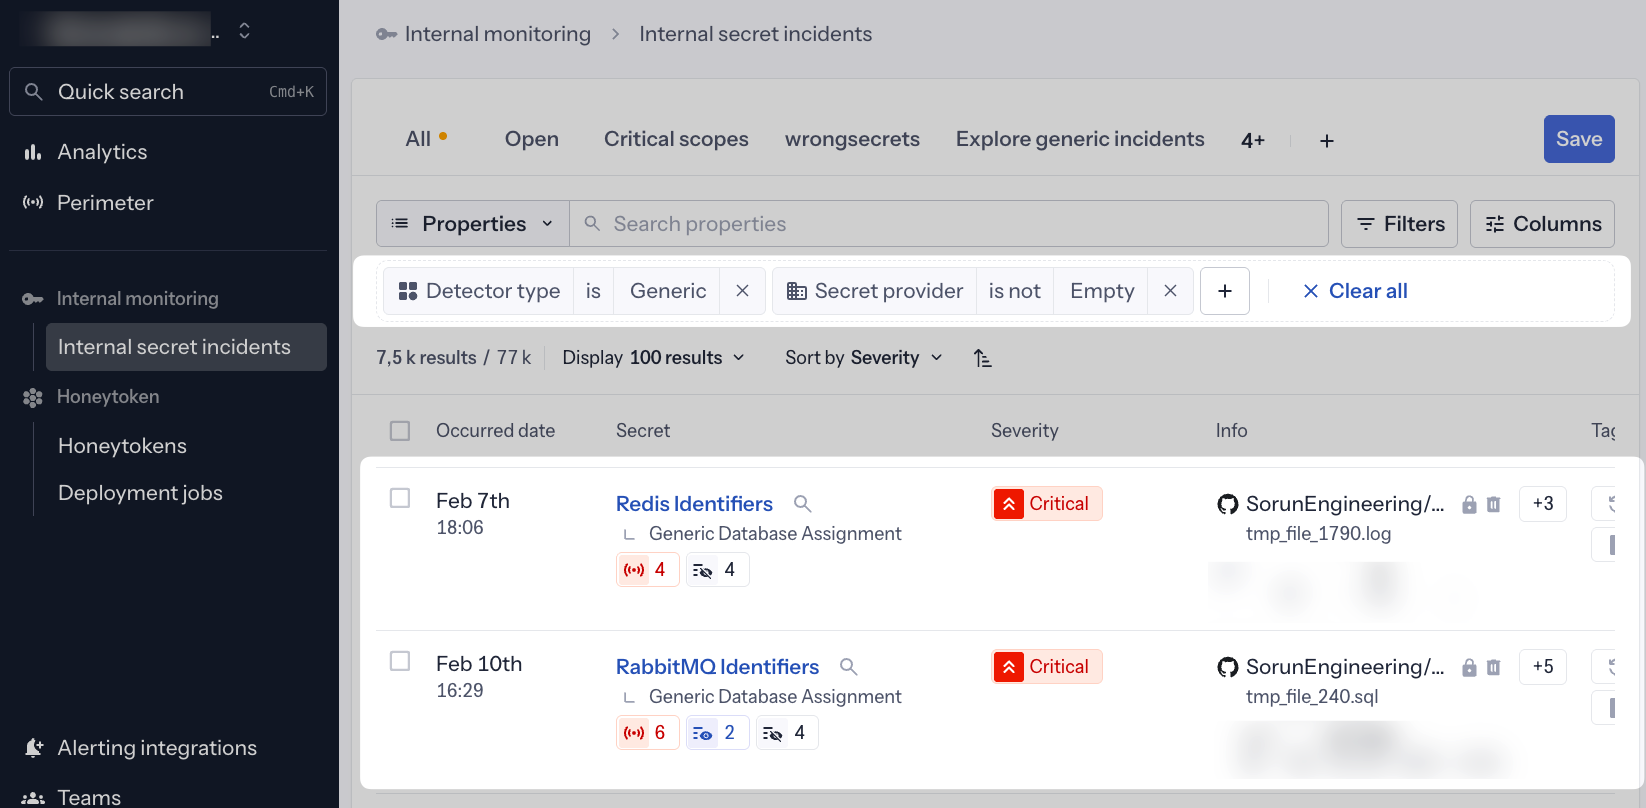
Cette UX pilotée par l'enrichissement fournit un contexte immédiat en un coup d'œil, éliminant le besoin d'ouvrir chaque incident pour comprendre quel type de secret a été exposé. Les noms enrichis apparaissent dans :
- Les listes d'incidents
- Les résultats de recherche
- Les réponses de l'API
- Les exports CSV et JSON
Dans certains cas, le nom du détecteur (par exemple, « Generic High Entropy Secret ») peut être visible au lieu du nom enrichi. Nous travaillons sur cette harmonisation tout au long des premiers mois de 2026.
Comment les catégories de Secret Enricher aident à la remédiation
Comprendre les catégories de Secret Enricher vous aide à :
- Prioriser les secrets d'infrastructure critique (fournisseurs Cloud, bases de données, etc.)
- Vous concentrer sur les services à fort impact (systèmes de paiement, fournisseurs d'identité, etc.)
- Identifier les secrets susceptibles d'affecter les opérations métier (systèmes de messagerie, plateformes e-commerce, etc.)
- Rationaliser les flux de travail de remédiation en regroupant des types de secrets similaires
- Appliquer des politiques de sécurité appropriées en fonction du type de service
Comment l'utiliser ?
Noms enrichis dans les listes d'incidents
Les noms de secrets enrichis sont automatiquement affichés comme nom principal de l'incident dans vos listes d'incidents. Aucune configuration n'est nécessaire — lorsque notre modèle de ML identifie avec succès un type de secret, vous le voyez immédiatement.
Cette approche pilotée par l'enrichissement rend le tri des incidents plus rapide et plus intuitif. Vous pouvez identifier instantanément :
- Les identifiants de base de données (Redis, PostgreSQL, MongoDB)
- Les secrets de fournisseurs Cloud (AWS, Azure, GCP)
- Les tokens de systèmes de paiement (Stripe, PayPal, Square)
- Les clés API pour des services spécifiques (Twilio, SendGrid, Slack)
Personnaliser vos vues
Depuis la liste des incidents, vous pouvez personnaliser l'affichage de vos incidents en cliquant sur le bouton « Columns » dans le coin supérieur droit du tableau.
Cela vous permet d'ajouter les colonnes « Secret category » et « Secret provider », qui affichent des propriétés d'enrichissement supplémentaires inférées par le modèle aux côtés du nom du secret enrichi.
Grâce à cette personnalisation, vous pouvez rapidement repérer les catégories importantes (telles que « Data Storage ») ou des fournisseurs spécifiques qui pourraient nécessiter une attention immédiate parmi vos incidents.
Filtrer vos données
Trois filtres (Provider, Category, Family) vous aident à identifier les incidents génériques les plus significatifs ou critiques, tels que ceux classés sous « Data Storage » ou liés au fournisseur « Postgresql ».
Vous pouvez appliquer ces filtres de plusieurs manières :
Exemple 1 > Filtrer directement les incidents enrichis : Utilisez « Detector Type is Generic » + « Secret Provider is not Empty » pour trouver les secrets génériques enrichis avec au moins un fournisseur inféré
Exemple 2 > Regrouper les incidents génériques par Secret Category : Utilisez « Detector Type is Generic » + « Secret Category is Data Storage » pour trouver les secrets génériques enrichis liés à la gestion/au stockage de données
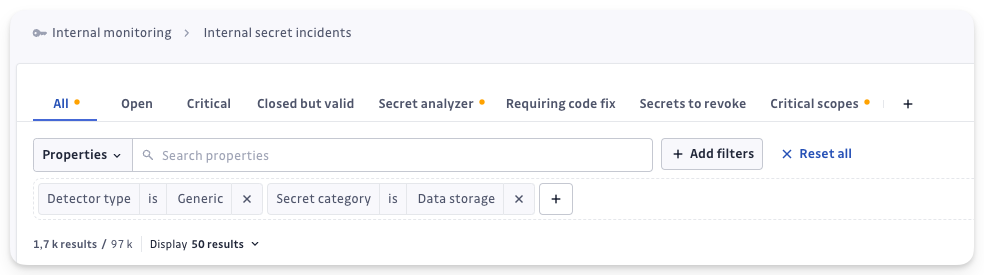
Avec ces filtres, vous pouvez explorer vos incidents enrichis et identifier rapidement ceux qui comptent le plus pour vos opérations.
Référence des catégories et fournisseurs
Pour des définitions détaillées de toutes les catégories et fournisseurs GSE, y compris leur signification et la manière de les prioriser, consultez notre référence complète des catégories et fournisseurs GSE.
FAQ
Que se passe-t-il si un secret ne peut pas être enrichi ?
Si le modèle de ML ne peut pas identifier un fournisseur ou une catégorie avec confiance, l'incident conservera son nom de détecteur générique d'origine (comme « Generic Database Assignment »). Vous pouvez toujours utiliser nos capacités de filtrage pour trouver et examiner ces incidents non enrichis.
Pourquoi ne sont-ils pas transformés en incidents spécifiques ?
Les incidents enrichis restent classés comme « génériques » du point de vue de la détection, car l'enrichissement repose sur une analyse contextuelle, et non sur des règles de détection basées sur des motifs. Cependant, le nom enrichi fournit la spécificité exploitable dont vous avez besoin pour la priorisation et la remédiation. À mesure que nous continuons d'affiner cette fonctionnalité, nos définitions deviendront plus précises, et nous pourrons convertir les enrichissements à haute confiance en détecteurs spécifiques.
Que le modèle est-il entraîné à découvrir ?
Le modèle peut identifier un ensemble complet de catégories et de fournisseurs :
Le modèle peut identifier les catégories suivantes :
- AI
- CDN
- CI/CD
- Cloud provider
- Code analysis
- Collaboration tool
- CRM
- Cryptos
- Data storage
- E-commerce
- Identity provider
- Internal
- Messaging system
- Monitoring
- Other
- Package registry
- Payment system
- Private key
- Remote access
- Secret management
- Social network
- Version control platform
Le modèle peut identifier des centaines de fournisseurs, notamment :
- Amazon AWS and related services
- Microsoft Azure and related services
- Google Cloud Platform
- Popular databases (PostgreSQL, MySQL, MongoDB, Redis)
- CI/CD platforms (GitHub, GitLab, Jenkins, CircleCI)
- Payment systems (Stripe, PayPal, Square)
- AI services (OpenAI, Anthropic, Hugging Face)
- Messaging platforms (Slack, Discord, Twilio)
- And many more...
Pour la liste complète des catégories et fournisseurs pris en charge, consultez la référence des catégories et fournisseurs GSE.
Risk score (priorisation des incidents pilotée par le ML)
Le risk score est une fonctionnalité pilotée par le machine learning qui évalue automatiquement le niveau de risque de chaque incident sur une échelle de 0 à 100, où 100 indique le risque le plus élevé et 0 le plus faible. Il analyse plusieurs signaux de risque, y compris le type de secret, la validité, le contexte d'exposition et les schémas comportementaux, pour vous aider à vous concentrer sur les incidents qui représentent la plus grande menace.
Le risk score utilise des modèles de machine learning qui sont continuellement améliorés sur la base des retours utilisateurs. Si vous remarquez des incidents avec des scores ou des explications inattendus, nous vous encourageons à partager vos retours directement via le dashboard — votre contribution nous aide à affiner le modèle de scoring.
Capacités clés
- Évaluation automatique du risque pour tous les incidents de secret (Internal et Public Monitoring)
- Scoring dynamique qui se met à jour à mesure que le contexte de l'incident évolue
- Explications en langage naturel générées pour chaque incident
- Priorisation granulaire avec une échelle de 0 à 100 pour des flux de travail de remédiation affinés
- Boucle de rétroaction pour l'amélioration future du modèle
Où l'utiliser
Le risk score est disponible dans le cadre des fonctionnalités de priorisation et d'examen des incidents :
- Risk score pour Internal Monitoring
- Risk score pour Public Monitoring - remplacé par l'analyse des agents sur les workspaces qui ont été basculés
Cette fonctionnalité fait partie de l'initiative ML plus large de GitGuardian visant à améliorer à la fois la précision de la détection et l'efficacité de la remédiation.
Regroupement d'incidents similaires (piloté par le ML)
Le regroupement d'incidents similaires est une fonctionnalité pilotée par le machine learning qui identifie et regroupe automatiquement les incidents liés en fonction de similarités contextuelles. Au lieu d'examiner les incidents un par un, vous pouvez traiter ensemble des groupes entiers d'incidents similaires, ce qui accélère considérablement votre flux de travail de remédiation.
Capacités clés
- Regroupement automatique des incidents partageant des caractéristiques similaires (contexte de code similaire dans le patch)
- Actions de remédiation en masse pour résoudre plusieurs incidents liés à la fois
- Mises à jour dynamiques des groupes à mesure que de nouveaux incidents sont détectés ou que les existants sont résolus
Comment cela aide
Le regroupement d'incidents similaires vous aide à :
- Réduire le temps de remédiation en traitant des groupes d'incidents liés ensemble plutôt qu'individuellement
- Identifier les problèmes systémiques lorsque le même type de secret apparaît à plusieurs emplacements
- Appliquer une remédiation cohérente à des incidents similaires pour maintenir la cohérence de la politique de sécurité
- Vous concentrer sur les incidents uniques en traitant d'abord rapidement les groupes d'incidents similaires
Où l'utiliser
Le regroupement d'incidents similaires est disponible dans les flux de travail de remédiation des incidents :
Cette fonctionnalité fait partie de l'initiative ML plus large de GitGuardian visant à améliorer à la fois la précision de la détection et l'efficacité de la remédiation.

