Applicative metrics
Exporter les métriques applicatives vers Prometheus
GitGuardian expose les métriques applicatives au format Prometheus, afin que vous puissiez les collecter pour la surveillance et les alertes.
L'exporteur Prometheus n'est pas pris en charge pour les embedded clusters.
Métriques disponibles
GitGuardian exporte les métriques suivantes, regroupées par domaine.
Les métriques sont listées avec les noms exposés dans Prometheus. Certaines jauges se terminent également par _total, vérifiez donc la colonne Type avant d'utiliser rate().
Prometheus ajoute _bucket, _sum et _count aux noms d'histogrammes, même lorsque le nom se termine déjà par _bucket. Par exemple, gim_celery_task_runtime_bucket est interrogé sous la forme gim_celery_task_runtime_bucket_bucket.
Sur les instances self-hosted, le label plan est toujours on_prem.
Où les métriques sont servies
Chaque métrique est servie par le pod qui l'enregistre :
- Service
app-exporter: jauges calculées à partir de la base de données et de Redis (utilisateurs, incidents, commits, scans actifs, infrastructure, longueur de file d'attente, installations, vérifications de santé, tâches périodiques, ainsi que le quota, l'usage et les tokens de la Public API). - Pods Celery worker (port
9808) : métriques enregistrées par les tâches en arrière-plan, qui couvrent la plupart des compteurs et histogrammes de cette page. - Pods d'application web (
/metricssur le port5050, ou5051pourpublic-api) : métriques enregistrées lors du traitement des requêtes, telles que les requêtes HTTP, l'authentification, SCIM, les appels à la Public API et les événements de webhook reçus par les podshook.
Les Service Monitors fournis couvrent app-exporter, les Celery workers et le ML Secret Engine lorsqu'il est déployé. Ils ne couvrent pas les pods d'application web, à l'exception des pods hook lorsque observability.exporters.webAppExporter.enabled est true. Pour collecter les métriques des autres pods d'application web, ajoutez votre propre ServiceMonitor ou PodMonitor.
Chaque pod ne rapporte que ses propres valeurs, agrégez donc les données entre les pods dans vos requêtes.
Utilisateurs et incidents
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_active_users_total | Gauge | Tous les utilisateurs de l'instance | Aucune |
gim_billable_users_total | Gauge | Développeurs contributeurs comptabilisés dans votre licence | Aucune |
gim_issues_total | Gauge | Tous les incidents | severity, status |
gim_occurrences_total | Gauge | Toutes les occurrences | hidden, status |
Activité de scan
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_commits_total | Gauge | Commits traités | account, scan_type |
gim_repo_scan_active_statuses_total | Gauge | Scans actuellement en attente ou en cours, par fonctionnalité de scan | scan_feature, status, plan |
gim_scan_ended_total | Counter | Scans terminés, avec ou sans succès | framework_version, source_type, status, scan_type, plan, failure_reason, exception, fault_domain |
gim_scan_pending_duration_seconds | Histogram | Temps qu'un scan a passé en attente avant son lancement | framework_version, source_type, status, scan_type, plan |
gim_scan_duration_seconds | Histogram | Durée du scan, du lancement à la fin | framework_version, source_type, status, scan_type, plan |
gim_scan_total_duration_seconds | Histogram | Durée de scan de bout en bout, de la création à la fin | framework_version, source_type, status, scan_type, plan, trigger_origin, trigger_family |
gim_scan_elements_scanned_total | Counter | Éléments scannés | source_type, scan_method, plan |
gim_scan_elements_skipped_total | Counter | Éléments ignorés pendant les scans | source_type, reason, plan |
gim_scan_elements_failed_total | Counter | Éléments ayant échoué pendant les scans | source_type, reason, plan |
gim_scan_data_downloaded_bytes_total | Counter | Octets téléchargés depuis les sources pendant les scans | source_type, plan |
gim_scan_data_scanned_bytes_total | Counter | Octets scannés à la recherche de secrets pendant les scans | source_type, plan |
gim_historical_scan_failure_total | Counter | Déprécié, utilisez gim_scan_ended_total. Scans terminés sans succès | integration_name, scan_feature, scan_status, exception, failure_reason |
gim_historical_scan_duration_seconds_bucket | Histogram | Durée des scans de dépôts et des scans historiques ou récurrents d'autres sources | scan_feature, plan |
gim_vcs_scan_deferred_total | Counter | Scans VCS différés car le workspace a atteint son nombre maximal de scans VCS simultanés | retry_number |
gim_vcs_scan_retry_scheduled_total | Counter | Nouvelles tentatives de scan VCS planifiées après un échec | source_type, failure_reason |
gim_vcs_scan_retry_outcome_total | Counter | Statut final des nouvelles tentatives de scan VCS | source_type, status |
gim_vcs_clone_time_seconds_bucket | Histogram | Temps nécessaire pour cloner un dépôt | integration_name, plan, clone_method |
gim_tokenscanner_content_oversized_total | Counter | Contenu non scanné car il dépasse la taille de scan maximale | caller |
- Dans
gim_repo_scan_active_statuses_total, la sériescan_feature="check_run_pr"répète des scans déjà comptés soussecrets. Excluez-la lors de l'addition entre les fonctionnalités. - Les métriques
gim_scan_pending_duration_seconds,gim_scan_elements_*etgim_scan_data_*ne couvrent que les sources non-VCS (par exemple Slack, Jira ou Confluence). gim_historical_scan_failure_totalcompte les scans échoués, expirés, ignorés, annulés et trop volumineux. Utilisezscan_statuspour les distinguer.- La limite sur les scans VCS simultanés est désactivée par défaut, donc
gim_vcs_scan_deferred_totalne rapporte généralement aucune donnée.
Check runs GitHub
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_check_runs_init_total | Counter | Check runs initialisés, qu'ils finissent ou non par être créés | created, setting_from, plan |
gim_check_runs_created_total | Counter | Check runs GitHub créés | plan, account_id |
gim_check_runs_timed_out_total | Counter | Check runs GitHub ayant expiré | plan, account_id |
gim_check_runs_runtime_bucket | Histogram | Durée des check runs GitHub, y compris le temps en file d'attente | status, plan |
gim_check_runs_error_codes_total | Counter | Erreurs des check runs GitHub par code | error_code |
gim_check_runs_pr_too_large_skipped_total | Counter | Check runs terminés comme neutres sans scan, car la pull request dépassait un seuil de taille | plan, reason |
gim_check_runs_pr_too_large_scan_dispatched_total | Counter | Pull requests trop volumineuses pour le chemin de check run normal, scannées à la place avec un check run basé sur un scan | plan, reason |
gim_check_runs_softtimelimit_retry_skipped_total | Counter | Check runs non relancés après avoir atteint la limite de temps de la tâche | placeholder |
gim_github_call_errors_total | Counter | Erreurs GitHub lors de la liste des pull requests d'une branche, comptées sur les check runs relancés | action, error_class |
Pour les métriques pr_too_large, reason est le seuil dépassé : commits, files ou changes.
Surveillance en temps réel
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_realtime_event_received_total | Counter | Événements en temps réel reçus des intégrations | integration_name, event_type |
gim_realtime_event_evaluation_started_total | Counter | Événements en temps réel dont l'évaluation a commencé | integration_name, plan, event_type |
gim_realtime_event_evaluation_success_total | Counter | Événements en temps réel évalués avec succès | integration_name, plan, event_type |
gim_realtime_event_evaluation_failure_total | Counter | Événements en temps réel dont l'évaluation a échoué et qui ne seront pas relancés | integration_name, exception, plan, event_type |
gim_realtime_event_retry_total | Counter | Événements en temps réel relancés après que leur évaluation a atteint la limite de temps de la tâche | integration_name, exception, plan, event_type |
gim_realtime_event_dropped_total | Counter | Événements en temps réel abandonnés | integration_name, plan, event_type |
gim_realtime_elements_scanned_total | Counter | Éléments en temps réel scannés à la recherche de secrets | integration_name, plan |
gim_realtime_elements_skipped_total | Counter | Éléments en temps réel ignorés avant le scan | integration_name, plan, reason |
gim_realtime_elements_failed_total | Counter | Éléments en temps réel ayant échoué pendant le scan | integration_name, plan, exception |
Incidents et secrets
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_issue_seen_total | Counter | Incidents vus dans les scans | policy_name, type, kind, detector_name |
gim_occurrence_seen_total | Counter | Occurrences vues dans les scans | integration_name, policy_name, type, kind |
gim_secret_validity_check_duration_seconds | Histogram | Durée des vérifications de validité des secrets | detector_name, validity_status, has_custom_host, timed_out |
gim_secret_validity_status_transition_total | Counter | Résultats des vérifications de validité, par ancien et nouveau statut de validité, y compris les statuts inchangés | detector_name, previous_status, new_status |
gim_presence_check_duration_seconds | Histogram | Durée des vérifications de présence | kind |
gim_presence_check_success_total | Counter | Occurrences vérifiées pour leur présence | kind |
gim_presence_check_updated_total | Counter | Occurrences mises à jour par les vérifications de présence | kind, presence_value |
gim_playbook_activated_total | Counter | Playbooks activés | playbook_type, is_public |
gim_playbook_deactivated_total | Counter | Playbooks désactivés | playbook_type, is_public |
gim_playbook_issues_resolved_total | Counter | Incidents résolus par les playbooks | playbook_type, is_public |
gim_playbook_issues_ignored_total | Counter | Incidents ignorés par les playbooks | playbook_type, is_public |
gim_playbook_issues_unignored_total | Counter | Incidents dé-ignorés par les playbooks | playbook_type, is_public |
Infrastructure
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_postgres_used_disk_bytes | Gauge | Taille de la base de données PostgreSQL de GitGuardian, hors fichiers WAL | Aucune |
gim_redis_used_memory_bytes | Gauge | Mémoire utilisée par l'instance de cache Redis | Aucune |
gim_redis_available_memory_bytes | Gauge | Mémoire totale de l'hôte exécutant Redis | Aucune |
gim_redis_available_memory_bytes correspond à la valeur total_system_memory de Redis, et non à maxmemory ou à une limite de mémoire de conteneur. Sur Kubernetes, il s'agit de la mémoire du nœud exécutant Redis.
Celery workers et files d'attente
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_celery_queue_length | Gauge | Tâches en attente dans la file | queue_name, team |
gim_celery_active_consumer_count | Gauge | Processus workers consommant la file, rapportés par chaque pod worker | queue_name, team |
gim_celery_worker_up | Gauge | Celery workers en cours d'exécution, chacun rapportant 1 une fois démarré | placeholder |
gim_celery_worker_tasks_active | Gauge | Tâches en cours de traitement | placeholder |
gim_celery_task_sent_total | Counter | Tâches envoyées à une file | name, queue_name, team |
gim_celery_task_received_total | Counter | Tâches reçues par un worker | name, queue_name, team |
gim_celery_task_started_total | Counter | Tâches démarrées par un worker | name, queue_name, team |
gim_celery_task_succeeded_total | Counter | Tâches terminées avec succès | name, queue_name, team |
gim_celery_task_failed_total | Counter | Tâches ayant échoué | name, exception, queue_name, team |
gim_celery_task_retried_total | Counter | Tâches relancées | name, queue_name, team |
gim_celery_task_revoked_total | Counter | Tâches révoquées | name, queue_name, team |
gim_celery_task_queue_time_bucket | Histogram | Temps passé en attente dans la file | name, queue_name, team |
gim_celery_task_runtime_bucket | Histogram | Durée d'exécution des tâches terminées avec succès | name, queue_name, team |
Le label placeholder est toujours ok. Les tâches envoyées lors du traitement d'une requête sont comptées dans gim_celery_task_sent_total par les pods d'application web. Les tâches périodiques envoyées par le planificateur Celery beat ne sont pas comptées.
Requêtes HTTP
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_http_request_started_total | Counter | Requêtes HTTP initiées | api, method, view_name |
gim_http_request_success_total | Counter | Requêtes HTTP ayant renvoyé un statut inférieur à 400 | api, method, view_name, plan, ggshield_command, business_account_id |
gim_http_request_failure_total | Counter | Requêtes HTTP ayant renvoyé un statut 4xx ou 5xx | api, method, status_code, view_name, plan, ggshield_command, business_account_id |
gim_http_request_exception_total | Counter | Requêtes API où la vue a levé une exception non gérée | api, method, view_name, exception, plan |
gim_http_request_view_duration_seconds_bucket | Histogram | Temps passé dans la vue, hors middleware | api, method, view_name, plan |
gim_http_request_middleware_before_duration_seconds_bucket | Histogram | Temps passé dans le middleware avant la vue | api |
gim_http_request_middleware_after_duration_seconds_bucket | Histogram | Temps passé dans le middleware après la vue | api |
gim_http_request_body_bytes_bucket | Histogram | Taille du corps de la requête, extraite de l'en-tête Content-Length | api |
gim_requests_with_invalid_host_header_total | Counter | Requêtes rejetées à cause d'un en-tête Host invalide | api, method |
Intégrations et vérifications de santé
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_installations_total | Gauge | Installations d'intégrations dans n'importe quel état | integration_type, account_id |
gim_installations_status | Gauge | Installations d'intégrations par état | integration_type, account_id, state |
gim_installation_uptime_seconds | Histogram | Temps pendant lequel une installation est restée saine avant de devenir défaillante | integration_type, account_id |
gim_installation_downtime_seconds | Histogram | Temps pendant lequel une installation est restée défaillante avant de récupérer | integration_type, account_id |
gim_integration_oauth2_access_tokens_expiring_soon | Gauge | Tokens d'accès OAuth2 valides qui expirent dans la marge de renouvellement (Slack, Jira Cloud et Confluence Cloud) | integration |
gim_integration_api_call_success_total | Counter | Appels API réussis vers les intégrations | integration_name, method, status_code, api_endpoint |
gim_integration_api_call_failure_total | Counter | Appels API échoués vers les intégrations | integration_name, method, status_code, exception, api_endpoint |
gim_integration_api_call_retry_total | Counter | Nouvelles tentatives d'appels API vers les intégrations | integration_name, method, exception, api_endpoint |
gim_integration_api_call_rate_limit_total | Counter | Appels API vers les intégrations ayant atteint la limite de débit du fournisseur | integration_name, method, status_code, api_endpoint |
gim_integration_api_call_duration_total | Counter | Durée cumulée des appels API vers les intégrations, en secondes | integration_name, method, status_code, api_endpoint |
gim_integration_health_check_probe_failure_total | Counter | Sondes de vérification de santé échouées vers les intégrations, comptées séparément des échecs d'appels API | integration_name, method, status_code, exception, api_endpoint |
gim_integration_app_credential_invalid_total | Counter | Identifiants au niveau application d'une intégration rejetés par le fournisseur | integration_name, reason |
gim_integrations_oauth2_renewal_total | Counter | Tentatives de renouvellement de token OAuth2 | integration, outcome, failure_reason, attempt_number |
gim_integration_sync_runs_total | Counter | Exécutions de synchronisation d'installation | integration_name, sync_type, source_type, outcome |
gim_health_check_result_count | Gauge | Services par résultat de leur dernière vérification de santé, actualisé quotidiennement | service_name, status |
gim_outdated_health_check_count | Gauge | Vérifications de santé plus anciennes que l'intervalle périodique | service_name |
gim_health_check_skipped_total | Counter | Vérifications de santé ignorées | reason, service_name |
gim_health_check_duration_metric | Histogram | Durée d'exécution des vérifications de santé | service_name |
Certaines métriques d'intégration ne sont rapportées que par des intégrations spécifiques :
gim_integration_api_call_retry_total: Slack.gim_integration_api_call_rate_limit_total: GitLab, Microsoft Teams, SharePoint Online, OneDrive, Amazon ECR et Amazon S3. Tous sauf GitLab comptent également ces appels dansgim_integration_api_call_failure_total, donc n'additionnez pas les deux.gim_integration_app_credential_invalid_total: Microsoft Teams, SharePoint Online et OneDrive.
Notifications et e-mails
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_notifier_run_failure_total | Counter | Exécutions de notifier ayant échoué | notifier_name, exception, source_integration_name, event_type |
gim_ebn_send_notification_event_total | Counter | Tentatives d'envoi de notification, y compris les relances, les échecs et les notifications ignorées | event_type, ebn_service_name, is_retry |
gim_ebn_send_notification_event_success_total | Counter | Notifications envoyées avec succès | event_type, ebn_service_name, is_retry |
gim_ebn_send_notification_event_failure_total | Counter | Notifications dont l'envoi a échoué | event_type, ebn_service_name, is_retry, retryable |
gim_ebn_send_notification_event_ignored_total | Counter | Notifications ignorées sans être envoyées, par exemple lorsqu'un nouvel incident est déjà ignoré ou résolu | event_type, ebn_service_name, is_retry |
gim_ebn_send_notification_event_duration_seconds | Histogram | Temps nécessaire pour envoyer une notification | event_type, ebn_service_name, is_retry |
gim_email_sent_success_total | Counter | E-mails envoyés sans erreur, comptés par destinataire | template_name |
gim_email_sent_failure_total | Counter | E-mails dont l'envoi a échoué, comptés par destinataire | template_name, exception |
Les e-mails envoyés lors du traitement d'une requête, tels que les codes MFA, sont comptés par les pods d'application web. gim_email_sent_success_total augmente également lorsqu'aucun serveur d'e-mail (SMTP ou SendGrid) n'est configuré, même si aucun e-mail n'est envoyé.
Authentification et provisionnement
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_authentication_sso_method_total | Counter | Réponses SAML ayant passé les vérifications de signature et d'authentification, par méthode d'authentification rapportée par le fournisseur d'identité | auth_method, idp_type |
gim_saml_sso_flow_started_total | Counter | Connexions SAML SSO démarrées | idp_type |
gim_saml_sso_sca_received_total | Counter | Assertions SAML reçues du fournisseur d'identité | idp_type |
gim_saml_sso_sca_rejected_total | Counter | Assertions SAML rejetées | idp_type, error_type |
gim_mfa_code_generated_total | Counter | Codes MFA générés | flow, is_resend |
gim_mfa_rate_limit_total | Counter | Requêtes MFA rejetées par la limitation de débit | flow, kind |
gim_mfa_code_verification_total | Counter | Vérifications de code MFA | flow, is_success |
gim_scim_user_created_total | Counter | Utilisateurs créés via SCIM | account_id |
gim_scim_saml_user_created_total | Counter | Utilisateurs SAML créés via SCIM | account_id |
gim_scim_member_created_total | Counter | Appartenances créées via SCIM | account_id |
gim_scim_member_deleted_total | Counter | Appartenances supprimées via SCIM | account_id |
gim_scim_error_total_metric_total | Counter | Erreurs renvoyées par l'API SCIM | status_code, scim_type, operation |
gim_members_deactivated_total | Counter | Members désactivés | plan |
gim_members_reactivated_total | Counter | Members réactivés | plan |
Tâches périodiques
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_periodic_task_period_seconds | Gauge | Périodicité attendue d'une tâche | task_name, queue_name |
gim_periodic_task_not_run_for_seconds | Gauge | Temps écoulé depuis le dernier envoi de la tâche par le planificateur | task_name, queue_name |
Public API
| Métrique | Type | Description | Dimensions |
|---|---|---|---|
gim_public_api_quota_total | Gauge | Usage API maximal autorisé | account |
gim_public_api_usage_total | Gauge | Usage API actuel | account |
gim_public_api_token_total | Gauge | Tokens API actifs | account, type |
gim_public_api_scan_duration_seconds | Histogram | Durée des scans de contenu via l'API | is_business, preset_name, all_secrets, multiscan |
gim_public_api_scan_total_documents_size_bytes | Histogram | Taille totale des documents scannés via l'API | is_business, preset_name, multiscan |
gim_invalid_api_key_total | Counter | Appels API rejetés à cause d'une clé API invalide | method, path, api_type, view_name, reason, token_id |
gim_quota_limit_reached_total | Counter | Appels API rejetés car le quota a été atteint | plan, business_account_id |
gim_ggshield_calls_total | Counter | Appels effectués par ggshield | ggshield_version, ggshield_os_name, ggshield_python_version, ggshield_command |
Surveillance recommandée
Santé du système
| Métrique | À surveiller |
|---|---|
gim_celery_queue_length | Un arriéré qui ne cesse de croître est un signe précoce de saturation. |
gim_celery_active_consumer_count | Une chute signifie que des pods worker se sont arrêtés. Une file sans consommateur n'a aucune série : voir les exemples de requêtes ci-dessous. |
gim_postgres_used_disk_bytes | Suivez la croissance de la base de données. Surveillez également l'utilisation du disque du volume PostgreSQL. |
gim_redis_used_memory_bytes / gim_redis_available_memory_bytes | Un ratio élevé indique une pression mémoire sur l'hôte Redis. Pour détecter que Redis atteint sa propre limite, comparez avec maxmemory ou la limite de mémoire du pod. |
gim_periodic_task_not_run_for_seconds | Comparez avec gim_periodic_task_period_seconds pour détecter les tâches périodiques bloquées. |
API et intégrations
| Métrique | À surveiller |
|---|---|
gim_http_request_failure_total | Filtrez par status_code pour repérer les pics de taux d'erreur (en particulier 5xx). |
gim_http_request_view_duration_seconds_bucket | Suivez la latence des vues (P95/P99) pour détecter les ralentissements. Cela exclut le temps du middleware. |
gim_health_check_result_count | Filtrez par status="not_ok" pour détecter les intégrations défaillantes. Actualisé quotidiennement, il peut donc avoir jusqu'à un jour de retard. |
gim_integration_api_call_failure_total | Filtrez par integration_name et status_code pour repérer un fournisseur qui rejette ou fait échouer les appels API. |
gim_check_runs_timed_out_total | Un taux croissant signifie que les check runs GitHub ne se terminent pas à temps. |
gim_check_runs_pr_too_large_skipped_total | Un taux croissant signifie que davantage de pull requests sont ignorées pour cause de taille. |
gim_scan_ended_total | Filtrez par status!="finished" pour repérer les scans échoués, y compris ceux annulés. fault_domain indique d'où vient l'échec : gim (GitGuardian), customer (accès, ressources supprimées, limites de débit ou limites de taille de votre côté) ou provider (erreurs temporaires du fournisseur de source). Alertez sur fault_domain="gim". |
gim_installations_status | Comparez avec gim_installations_total pour suivre les installations par état. |
gim_ebn_send_notification_event_failure_total | Les échecs avec retryable="False" sont définitifs. Un taux soutenu signifie que les notifications ne sont pas envoyées. |
Les métriques de requêtes HTTP sont servies par les pods d'application web, que les Service Monitors fournis ne couvrent pas (voir Où les métriques sont servies).
Exemples de requêtes PromQL
# Celery queue saturation (waiting tasks per active consumer)
max by (queue_name) (gim_celery_queue_length) / sum by (queue_name) (gim_celery_active_consumer_count)

# Queues with waiting tasks and no active consumer (not shown by the saturation query above)
max by (queue_name) (gim_celery_queue_length) > 0 unless on (queue_name) sum by (queue_name) (gim_celery_active_consumer_count)

# HTTP 5xx error rate over the last 5 minutes
sum(rate(gim_http_request_failure_total{status_code=~"5.."}[5m]))

# View latency P95 over the last 5 minutes (excludes middleware time)
histogram_quantile(0.95, sum by (le) (rate(gim_http_request_view_duration_seconds_bucket_bucket[5m])))

# Redis memory as a share of the host's total memory (%)
gim_redis_used_memory_bytes / (gim_redis_available_memory_bytes > 0) * 100

# Periodic tasks the scheduler has not sent for 2x their expected period
gim_periodic_task_not_run_for_seconds > 2 * gim_periodic_task_period_seconds
Exemples de règles d'alerte
Voici des règles d'alerte Prometheus de départ que vous pouvez adapter à votre environnement :
groups:
  - name: gitguardian
    rules:
      - alert: CeleryQueueBacklog
        expr: max by (queue_name) (gim_celery_queue_length) > 100
        for: 5m
        annotations:
          summary: "Queue {{ $labels.queue_name }} has {{ $value }} pending tasks"

      - alert: RedisMemoryPressure
        expr: gim_redis_used_memory_bytes / (gim_redis_available_memory_bytes > 0) > 0.85
        for: 10m

      - alert: PeriodicTaskStalled
        expr: gim_periodic_task_not_run_for_seconds > 2 * gim_periodic_task_period_seconds
        for: 5m

      # Requires scraping the web application pods
      - alert: HighHTTPErrorRate
        expr: sum(rate(gim_http_request_failure_total{status_code=~"5.."}[5m])) > 0.1
        for: 5m
Si Redis a maxmemory défini ou une limite de mémoire de conteneur, ajustez le seuil RedisMemoryPressure.
Visualiser les métriques avec Grafana
GitGuardian ne fournit pas de dashboards Grafana préconstruits, mais toutes les métriques gim_* sont des métriques Prometheus standard et fonctionnent avec n'importe quelle instance Grafana connectée à votre serveur Prometheus.
Pour commencer :
- Ajoutez votre serveur Prometheus comme source de données Grafana.
- Créez des panneaux à l'aide des requêtes PromQL ci-dessus.
- Organisez les panneaux en lignes : System health (files d'attente, Redis, Postgres, tâches périodiques) et API and integrations (taux d'erreur, vérifications de santé).
Activer ou désactiver les métriques applicatives
Les pods Celery worker et d'application web exposent leurs métriques sans configuration supplémentaire. Pour activer les jauges app-exporter :
- autorisez la collecte des métriques par l'application
- activez l'export Prometheus
Autoriser la collecte des métriques
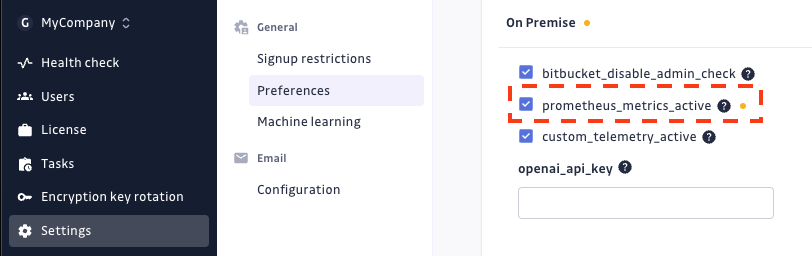
Dans l'Admin Area, allez dans Preferences, cochez le feature flag prometheus_metrics_active,
puis enregistrez.
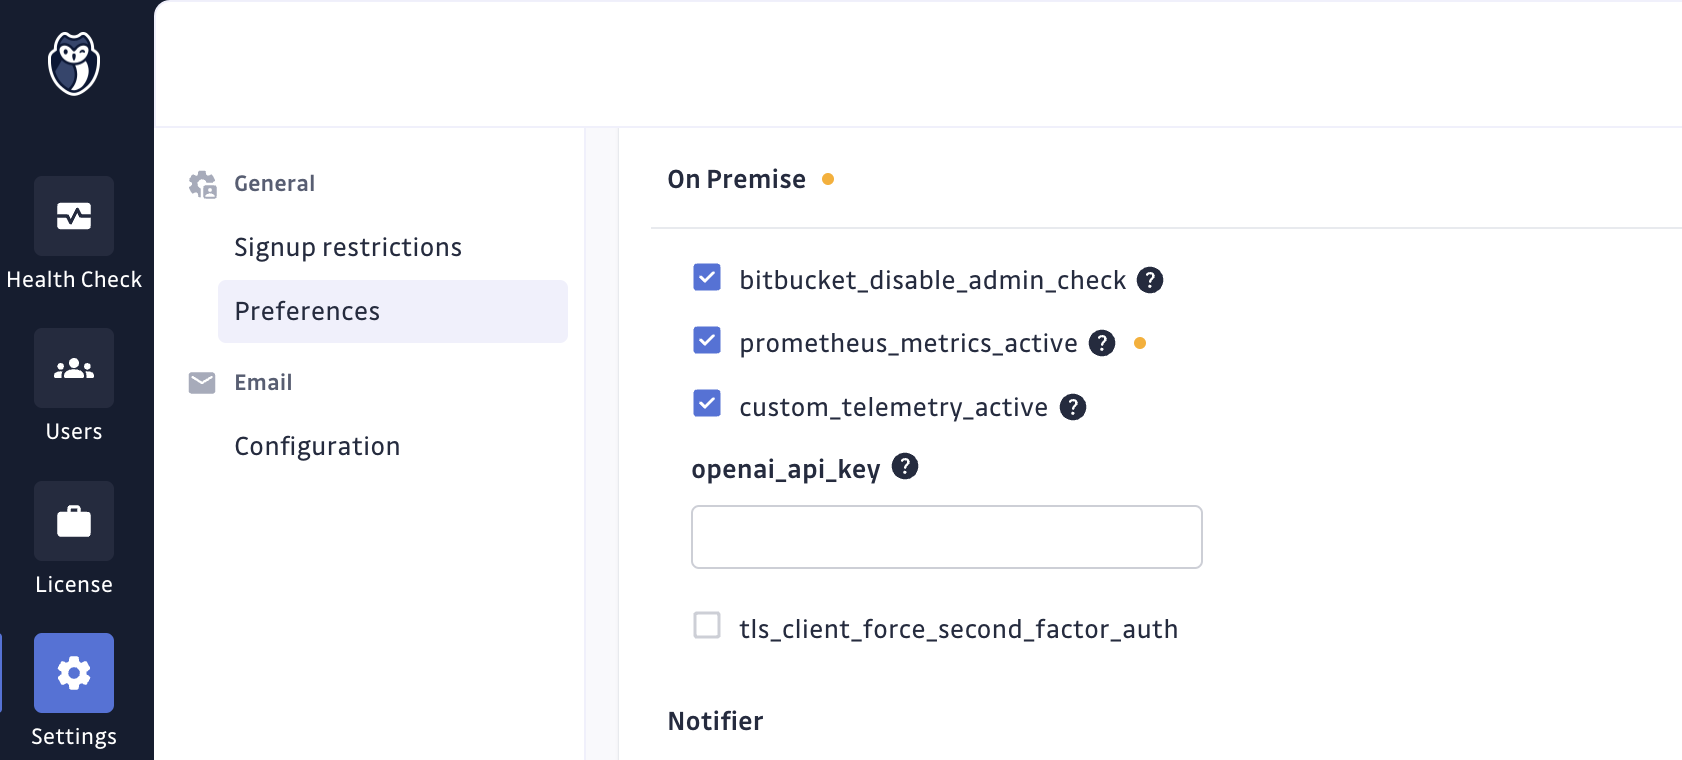
Pour la désactiver, décochez le flag et enregistrez.
Tant qu'elle est décochée, le service app-exporter renvoie une erreur 404. Les métriques des Celery workers et de l'application web ne sont pas affectées.
Installer Prometheus Operator
Les métriques sont collectées par Prometheus à l'aide de l' Prometheus Operator.
Sur les existing clusters, installez-le vous-même (documentation d'installation).
Activer l'export Prometheus avec KOTS
Dans la KOTS Admin Console, ouvrez la page de configuration et cochez Activate Prometheus Exporter dans la section Prometheus.
Enregistrez la configuration et Deploy l'application. Cela déploie le service app-exporter et crée les Service Monitors.
Pour la désactiver, décochez la case, enregistrez, puis redéployez.
Activer l'export Prometheus avec Helm
Pour déployer le service app-exporter, définissez observability.exporters.statefulAppExporter.enabled=true dans votre fichier de values.
observability:
  exporters:
    statefulAppExporter:
      enabled: true
Si vous utilisez Prometheus Operator, définissez observability.serviceMonitors.enabled=true pour créer les Service Monitors. Définissez observability.exporters.webAppExporter.enabled=true pour couvrir également les pods hook.
observability:
  exporters:
    webAppExporter:
      enabled: true
    statefulAppExporter:
      enabled: true
  serviceMonitors:
    enabled: true
Sinon, vous pouvez collecter manuellement les endpoints de métriques :
app-exporter:http://app-exporter.<namespace>.svc.cluster.local:9808/metrics- Celery workers : chaque pod sur le port
9808, à/metrics. Utilisez la découverte des endpoints Kubernetes pour collecter tous les pods, car le service worker (par exempleworkerouscanners) n'atteint qu'un seul pod par requête. - Pods d'application web : chaque pod à
/metrics, sur le port5050(5051pourpublic-api).
Comment collecter les métriques
Sur les existing clusters, vous installez et configurez Prometheus vous-même. Si vous utilisez la stack kube-prometheus avec les Service Monitors activés, Prometheus découvre automatiquement les pods couverts (voir Où les métriques sont servies).
Votre instance Prometheus doit sélectionner ces Service Monitors. Par exemple,
kube-prometheus-stack ne sélectionne que les Service Monitors qui portent son label
release. Avec Helm, définissez-le avec observability.serviceMonitors.labels (voir
Autoscaling).
Sinon, collectez les endpoints listés dans Activer l'export Prometheus avec Helm.
Données d'usage
GitGuardian collecte des données d'usage pour améliorer le produit et le support. Pour les désactiver,
décochez custom_telemetry_active dans la section préférences
de l'Admin area.
Pourquoi conserver les données d'usage activées ?
-
Amélioration du produit : les données d'usage nous montrent comment l'application s'exécute dans différents environnements, afin que nous sachions où concentrer les correctifs et les tests.
-
Support plus rapide : lorsqu'un problème survient, les données d'usage nous aident à le trouver et à le corriger plus rapidement, ce qui signifie moins de temps d'arrêt pour vous.
-
Confidentialité : nous ne collectons pas de données personnelles ou sensibles.
Voici les catégories et métriques que nous collectons :
-
Replicated
- Diverses métriques liées au déploiement, telles que le statut du cloud, la version et le temps de fonctionnement
-
System
- Fournisseur SSO
- Type de passerelle réseau
- Statut de la CA personnalisée et du proxy
- Statut d'activation des métriques applicatives Prometheus
-
Users & Teams
- Nombre d'invités en attente, d'utilisateurs enregistrés avec différents niveaux d'accès, d'utilisateurs actifs.
-
Billing
- Nombre de développeurs contributeurs comptabilisés dans votre licence, et le nombre exclu du décompte
- Les deux mêmes décomptes ventilés par type de VCS (Azure DevOps, Bitbucket Cloud, Bitbucket Data Center, Gerrit, GitHub, GitHub Enterprise, GitLab)
Il s'agit de décomptes agrégés d'adresses e-mail distinctes d'auteurs de commits. Les adresses e-mail elles-mêmes ne sont jamais transmises.
-
Historical Scan
- Nombre de scans historiques annulés, échoués et terminés
- Durées en percentiles des scans historiques
- Nombre de secrets trouvés par jour et de scans de sources par jour dans les scans historiques
- Nombre de scans historiques considérés comme trop volumineux
-
Integrations
- Nombre d'instances, d'installations, de projets, de sites pour les VCS et autres sources de données
- Nombre de sources surveillées et non surveillées, ainsi que les percentiles de taille des sources et les utilisateurs estimés par VCS
-
Secret
- Nombre de détecteurs désactivés par catégorie, de retours enregistrés et non enregistrés, et diverses métriques liées aux vérifications de validité des secrets et aux incidents
-
Public API
- Nombre d'appels pour les scans de secrets ggshield, y compris les différents modes et dépôts
- Nombre de tokens d'accès personnels et de comptes de service actifs
- Nombre d'appels à la public API

